En esta serie de artículos sobre lo que creo que debería ser la inteligencia artificial corporativa, hemos ido tocando una idea bastante provocadora: quizás el mayor problema de la inteligencia artificial empresarial tal como la conocemos hasta ahora no es la inteligencia, sino el nivel al que la estamos programando.
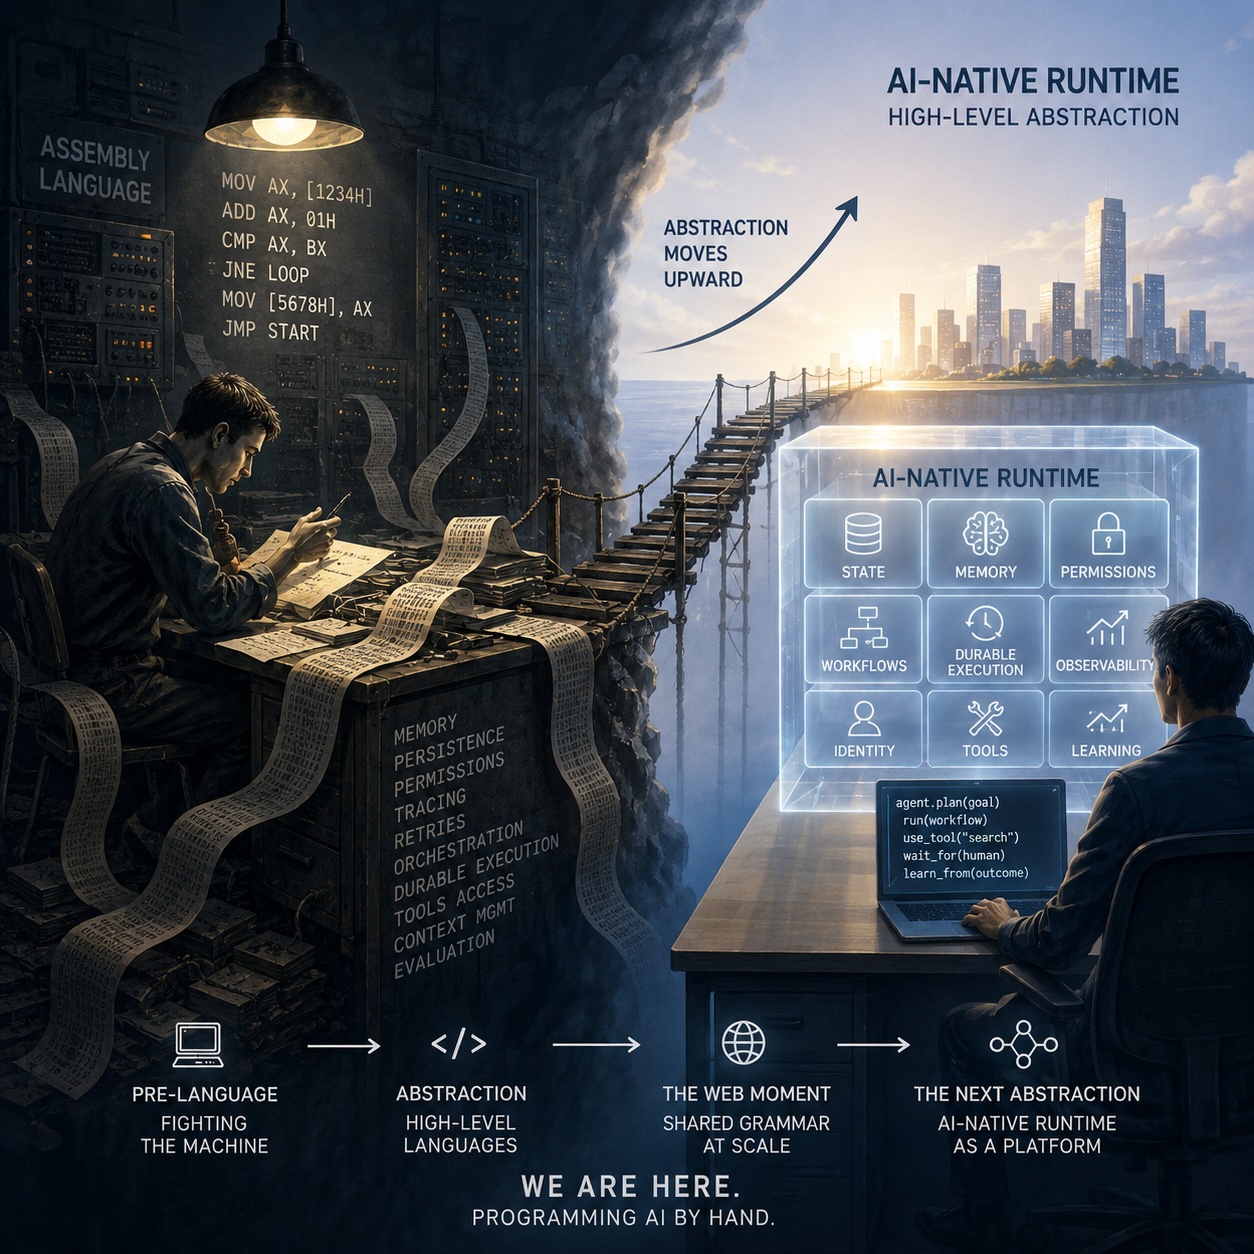
Hoy, los modelos de frontera, la infraestructura elástica en la nube, las bases de datos vectoriales, las APIs gestionadas y grandes cantidades de computación están al alcance de cualquier empresa seria. Como sustrato, es extraordinariamente potente. Sin embargo, para poner sistemas de inteligencia artificial en producción seguimos necesitando ingenieros que ensamblen a mano cosas tan fundamentales como la persistencia, la memoria, los permisos, el trazado, los reintentos, la orquestación, la ejecución durable, el acceso a herramientas, la gestión del contexto y la evaluación. Como decíamos antes, esto es como internet en 1991, antes de que existiera la web.
Hoy damos por descontados los lenguajes de alto nivel. Pero hace décadas, los desarrolladores tenían que pelear directamente con la máquina, en lenguaje máquina o ensamblador, algo que John Backus describió como «un combate cuerpo a cuerpo con la máquina«. En la historia de Fortran que publicó IBM, la empresa explica que había tareas que requerían hasta mil instrucciones máquina y que podían expresarse fácilmente con solo 47 sentencias Fortran, desvinculando además los programas de hardware específico. Fortran no hizo posible la computación, pero sí la hizo económicamente expresable a un nivel superior.
El mismo patrón lo vimos con C, con Java y con la web. Dennis Ritchie explica cómo C permitió reescribir el propio Unix en un lenguaje ampliamente portable, facilitando su migración entre máquinas. Después, Java convirtió la JVM más las bibliotecas estándar en una plataforma explícita, iniciando el movimiento «write once, run anywhere«. Luego la web transformó un internet ya funcional pero complejo introduciendo una gramática compartida y sencilla —HTML, HTTP y URLs— sobre el sustrato de red. En todos estos casos, la infraestructura existía de antes, pero la abstracción la hizo programable y manejable a gran escala.
La pila agéntica de hoy se parece mucho a otro período pre-lenguaje: usamos Python más frameworks y servicios para programar aplicaciones inteligentes, con cada pieza gestionando características fundamentales por separado. Ninguno de estos productos sobra, todo lo contrario, pero su proliferación también es una señal de que puede faltar todavía una abstracción subyacente. ¿Qué ocurre cuando un ecosistema crece para proveer individualmente propiedades que el sustrato no ofrece de manera natural? Sencillamente, que ese ecosistema empieza a leerse como una factura desglosada de una capa que falta.
¿Quién valida el problema del runtime? El mercado
Pensemos en LangChain: distingue explícitamente el arnés alrededor de un agente del runtime que hay debajo. Ellos mismos explican que los agentes en producción necesitan ejecución durable, memoria, multi-tenancy, supervisión humana en el bucle, observabilidad, sandboxes, integraciones y planificación. Y aclaran que «para construir un buen agente necesitas un buen arnés; y para desplegarlo, necesitas un buen runtime«. ¿Da eso una pista?
Otro ejemplo: Temporal recaudó 300 millones de dólares en febrero a una valoración de 5,000 millones vendiendo la idea de que las aplicaciones de inteligencia artificial de larga duración y con estado necesitan una capa de ejecución durable, lo cual es verdad. Pero en su arquitectura de referencia, las llamadas al LLM y los efectos secundarios externos tienen que envolverse cuidadosamente para que el estado del flujo de trabajo sea reproducible y recuperable. Es sofisticado, sin duda, pero también es la prueba de que seguimos ensamblando manualmente primitivas que un runtime nativo de inteligencia artificial futuro podría razonablemente hacer intrínsecas.
LangGraph o la propia Anthropic cuentan la misma historia desde ángulos distintos. La pila actual puede construir casi cualquier cosa, sí, pero a un coste considerable. Y ese coste, como ocurrió hace tiempo con el ensamblador, es una complejidad extraordinaria. Con ensamblador se podía hacer software increíble, claro, pero el coste de ingeniería, la fragilidad y la falta de una abstracción reutilizable nos obligaban a reinventar la rueda. Una y otra vez. Hoy, con Python más bases de datos más colas más orquestación más trazado más almacenes de memoria, podemos producir excelentes sistemas de inteligencia artificial, pero cada equipo tiene que resolver los mismos problemas una y otra vez.
Como he dicho antes, las metáforas no industrializan bien. Para que el software sea verdaderamente industrial, la capacidad tiene que seguirse de la formalización. ¿Ejemplos? El modelo relacional de Codd apareció antes que el ecosistema de bases de datos. Los estándares web precedieron a la economía web. Y el ERP creó las abstracciones empresariales compartidas que seguimos usando. La formalización tiene que alcanzar en algún momento al propio runtime. Cosas tan importantes como la memoria, el estado, los permisos, los flujos de trabajo, la ejecución con journal y el aprendizaje tienen que convertirse en primitivas, no en bibliotecas pegadas después con cinta adhesiva.
La distinción importante: entre un framework de agentes y un runtime nativo de inteligencia artificial
Cuando se escribe software convencional, los desarrolladores no tienen que implementar manualmente cosas como la memoria virtual, la planificación de procesos o la semántica del sistema de archivos en cada aplicación. Cuando un sustrato madura, puede proporcionar esas propiedades de forma automática. Pero por alguna razón, cuando luchamos por desarrollar inteligencia artificial empresarial, seguimos tratando cosas tan importantes como la identidad persistente del agente, el acceso gobernado, los historiales estructurados y las señales de aprendizaje como problemas únicos que hay que resolver cada vez, caso por caso. Esto no tiene ningún sentido: todas esas cosas deberían ser propiedades del runtime, no productos externos que hay que ensamblar manualmente cada vez como si fuéramos artesanos.
Se puede seguir la pista de manera bastante obvia mirando dónde aparecen las startups: la memoria, la ejecución durable, la observabilidad, el sandboxing, los guardrails, la identidad del agente y la orquestación se están convirtiendo todos en categorías propias, con empresas que brotan como setas y levantan cantidades interesantes de dinero. Eso es bueno para los emprendedores y para el ecosistema, supongo, pero históricamente es una señal temprana que precede a la abstracción. ¿Serán estas capas permanentemente independientes, o estamos viendo cómo una industria vende temporalmente por separado las piezas que un runtime futuro acabará absorbiendo y fusionando?
Las cosas cambiarán (tarde o temprano)
¿Sabes qué tiene de extraordinario la era actual de la inteligencia artificial corporativa? Que ya hemos construido el equivalente del mainframe, la red y la nube computacional, pero seguimos programando la mayor parte de la capa inteligente puramente a mano, línea a línea, con sangre, sudor y lágrimas. Cuando los desarrolladores del futuro miren los intrincados wrappers de Python, las bases de datos de checkpoints, las colas, los sistemas de trazado, los almacenes de memoria y los grafos de orquestación de hoy, los verán igual que nosotros vemos hoy los primeros listados en ensamblador: asombrosos, laboriosos, impresionantes para su época, y sorprendentes porque toda esa complejidad se consideró en su momento necesaria.
Piénsalo con perspectiva histórica: si todo gran sustrato computacional acabó adquiriendo un lenguaje y un runtime que expresaba sus abstracciones nativas, ¿por qué iba a ser diferente la inteligencia artificial? Puedes pensarlo como un experimento mental, o como un deseo descabellado: ¿qué tendría que hacer nativas ese runtime para convertirse en la plataforma de tus sueños, la que haría mucho más fáciles tus implementaciones de inteligencia artificial corporativa? De momento, esa es la pregunta interesante. Pero tarde o temprano, puede que deje de ser solo un experimento mental…
(This article was previously published on Fast Company)

Esto del ensamblador creo que introduce una pregunta interesante: ahora que todo lo va a programar la IA, ¿desaparecerán todos los lenguajes de programación de alto nivel y ya sólo se usará C?
Yo creo que parcialmente sí, se crearán nuevos lenguajes de más alto nivel que sustituirán a los +usados actualmente. Insisto: Parcialmente.
Una pregunta relacionada con la tuya e interesante serán las migraciones de los actuales lenguajes propietarops a esos de más alto nivel o a lenguajes opensource actuales. Por Ejemplo: Hay una aplicación muy usada en los mainframes que se llama CICS y realiza transacciones en tiempo real embebida en el lenguaje COBOL. Yo creo que hoy es factible pedir a una IA migrar todos tus app COBOL-CICS a otro lenguaje en Linux con open source y ahorrarte un pastón en licencias
Alguna abstracción habrá. Cuando programas un videojuego tampoco andas instanciando variables para cada NPC o incluso para un personaje principal o cada árbol del bosque. Lo que se hace es un objeto, que a su vez es una abstracción de todo aquello de las variables (sigue siendo una…)
Para hacer un bosque o usan random(trees) a saco o ponen (tree1:pos1,3;tree2:pos4,6), etc. Y no dibujan el árbol pixel a pixel sino que instancian otra abstracción que alguien habrá creado en Blender.
Al final, todo tiende a simplicar los procesos. El que sepa «lo de abajo» podrá optimizar mejor, pero al final todo se hará simplificado.
Eso sí, que alguien me explique por qué una app de Android ocupa 180mb comprimida para meter un termómetro o que Tinder (siendo una API) necesite 85mb o que el Stratego necesite 117mb para instalarse. ¿Por qué están tan mal optimizados? Aquí la capa de abstracción parece miserable o el compilador es ridículo a la hora de crear las apps.
Si notepad se puede recrear en 2kb, ¿por qué narices una app para tomar notas ocupa 37mb?
No tengo la respuesta definitiva, pero sí una parte de la respuesta a tu interrogante sobre las «overweight applications», y está relacionada con la publicación de Enrique:
La factura invisible de que te vigilen
En esa publicación, él desarrolló el tema, pero desde la óptica del peso y el consumo de energía añadido de los sitios web que se dedican a analizar nuestros movimientos.
Ahora, haz la prueba, entra a cualquier tienda de aplicaciones, y mira cuanto pesan algunas de las aplicaciones más básicas, como linternas, lectores de pdf y los convertidores de divisas.
Cualquiera de esas mierdas que ahora, si te dedicaste a hacer un análisis previo del resultado que quieres obtener, se pueden hacer con 4 o 5 iteraciones de prompt en cualquier LLM usando sus modelos más capados, además de publicidad, están llenas de trackers y la basura que se te ocurra, y si te dedicas a analizar sus ToC y políticas de privacidad, usan términos tan vagos como:
* «nivel de seguridad razonable»
* «trabajaremos duro»
con lo cual el desarrollador ya te está advirtiendo que, a pesar de sus esfuerzos, no puede garantizar que no habrá hackeos o filtraciones de nuestros datos.
Sin contar con el hecho de que casi todas usan Firebase (Google) y Admob (Google). Aunque esto es estándar en aplicaciones gratuitas, lo que implica que nuestros datos de uso junto con el identificador de nuestro dispositivo (como el Android ID) son procesados por estos «benevolentes» gigantes tecnológicos para fines de publicidad y análisis.
Si te gusta jugar a Stratego, prueba a jugar aquí, es donde están los mejores jugadores del mundo y donde se organizan los mejores torneos online, sin tener que instalar nada.
https://strategus.appspot.com/play
Una delicia el artículo, como siempre. He pasado el verano programando videojuegos con Claude en MS-DOS y librerías en C para quitarme el gusanito y he llegado a la conclusión que llegará un momento cuando se abaraten los tokens que ya no tendrá sentido tener frameworks y la IA programará en lenguajes cada vez más bajos, hasta programar directamente en ensamblador. Dará igual que se reinvente la rueda si podremos disponer de código eficiente. Proyectos como WordPress que fueron el estandar, hoy pierden sentido si la propia IA te puede programar una web y un CMS a medida.
El eterno ensamblador. Puedes estar trabajando con lo mas moderno como la AI, pero debajo de todo sigue estando el ensamblador, Siempre tuve interés en aprenderlo pero nunca me puse a ello-
y debajo el binario…
10111000 00000100 00000000 00000000 00000000 10111011 00000001 00000000
00000000 00000000 10111001 00100100 10010000 00000100 00001000 10111010
00001011 00000000 00000000 00000000 11001101 10000000 10111000 00000001
00000000 00000000 00000000 00110001 11011011 11001101 10000000 01101000
01101111 01101100 01100001 00100000 01101101 01110101 01101110 01100100
01101111 00001010
Muy bonito el volcado binario. Pero ya que te has puesto ‘low level’: Sabes por qué el registro edx vale 0x0B (11) y no 10? XDDDDD
Porque EDX contiene la longitud del mensaje en bytes, no el número de letras sin contar el salto de línea.
Exacto. Veo que al final la IA te lo ha masticado bien y has aprendido la lección. Te doy el aprobado en el examen de ensamblador de hoy… XDDD
Lo que hice «en sus tiempos» fue crear un desemsamblador del Z80, hecho en Basic para poder leer ficheros y memoria RAM… tenía su gracia sin IA…, y algún pinito con peek y poke….
Hombre, todos hemos hecho POKE 23693,64 para tener infinitas vidas en el Manic Miner (me invento el poke), que la MicroHobby era de uso común, pero te reconozco el mérito de pasar de peeks y pokes en 8bits, a hacer llamadas a syscalls en 32/64…
Ya lo he comentado alguna vez (y a ti en privado) que empecé programando ASM y Forth, primero en un M65000, en Signetics 2650A, Z80 y al final en 8088/8086 (aunque esto ultimo ya mas bien poco)
Tuviste oportunidad de hacer algo con un Signetics? Eso si era oro puro… :P
Vaya, cómo se nota que nunca habéis estado en el submarino de «Viaje al fondo del mar», mi má.
Tu si, por supuesto, que siempre has estado alli donde los demas no… XDDD
Cómo lo sabes, macho, cómo lo sabes… :-)
Porque reconozco a los drogadictos a distancia, sean ilegales o subvencionados por la Seguridad Social…
y ya no os hago puto caso… XDDD
(y me vale igualmente para los que se cabrean cuando alguien habla de «alucinaciones de IA», y salís diciendo «que no sabemos que coño es una alucinación»)
Puta vida tete… pero es lo que hay….
Gorki, ‘siempre tuviste interés, pero nunca te pusiste a ello’…???
Y aun así nos contaste que inventaste el BASIC de Cedar Computer (junto con otros).
Supongo que es como decir que vendiste coches toda la vida sin saber cambiar una rueda.
¿Cómo se puede «inventar» un BASIC (aunque sea junto con otros) sin tener ni idea de ensamblador? Porque de C ya has dejado claro que tampoco tienes ni idea… aún espero respuestas sobre el tema de punteros, y sin punteros no hay nada.
Esto me ha recordado un tuit del gran Jaime Gómez-Obregón sobre ensambaldor:
« En álgebra de Boole, un XOR es una disyunción exclusiva: devuelve verdadero sí y solo sí uno de los operandos es verdadero, pero no ambos.
Entonces, la instrucción XOR DX, DX almacenará siempre en el registro DX del microprocesador el valor cero, pues cuando ambos operandos son idénticos, la salida es falsa. Es una instrucción equivalente a:
MOV DX, 0
Pero, ¿acaso no es esta última más directa y legible que la otra? ¿Qué sentido tiene inicializar una variable haciendo un XOR en lugar de, simplemente, asignarle un cero como toda la vida?
Hay una razón: la eficiencia.
En la arquitectura Intel 80×86, la instrucción MOV DX, 0 se ensambla en tres bytes y consume dos ciclos de reloj:
BA 00 00
En cambio, XOR DX, DX se ensambla en dos bytes y consume un solo ciclo:
31 D2
Hay un ahorro de un byte y un ciclo, que en un 386 a 33 MHz significa 30,3 nanosegundos. Es decir, unas treinta milmillonésimas partes de un segundo.
En un bucle que inicializa un megabyte de memoria, o que apaga cientos de miles de píxeles de una pantalla o que anula un fichero en el disco… esta precaución devengaba ahorros tangibles.
Hay otra microoptimización interesante aquí:
La instrucción INC BX incrementa el valor almacenado en el registro BX. Como está duplicada, equivale a:
ADD BX, 2
Solo que el primer camino consume dos bytes, mientras que el ADD —más legible, sí— requiere del doble.
Este tipo de optimizaciones son cruciales al programar un virus informático no destructivo —que es lo que hace el código— y otras aplicaciones sensibles, pe…
—¡Ya vale de batallitas de yayo! Esto no me sirve hoy para nada —quizá digas, al escuchar todo esto sentado mirando la fogata. …»
https://x.com/JaimeObregon/status/1906453601565786206
Lo primero, disculparme con Gorki y con Dedo. Ayer tuve un día negro y eso no justifica que disparara a matar. Si eDans tiene a bien borrar esas dos respuestas se lo agradeceré.
Alqvimista: Jaime lo resume en una palabra: eficiencia. ASM no era fácil, pero tampoco un descenso a los infiernos cuando ya lo dominabas un poco. El problema es que hoy día, para usar una función cargas toda una librería completa y de ahí, la queja de Benji, de que los programas ocupen mas (innecesariamente). “como tenemos mas maquina, no importa”.
Hace poco leí que Google pide a los desarrolladores que optimicen sus programas dado que los futuros teléfonos van a ir más bien justitos de RAM…
El problema es que hoy en día hay más juntalibrerias que programadores. Y ya con la IA la cosa se ha desmadrado y cualquier inútil es capaz de montar una app y subirla a la tienda.
También digo… si después de 36 años tuviera que volver a enfrentarme a ASM, tiraría de IA o me tiraría por la ventana… o las dos…