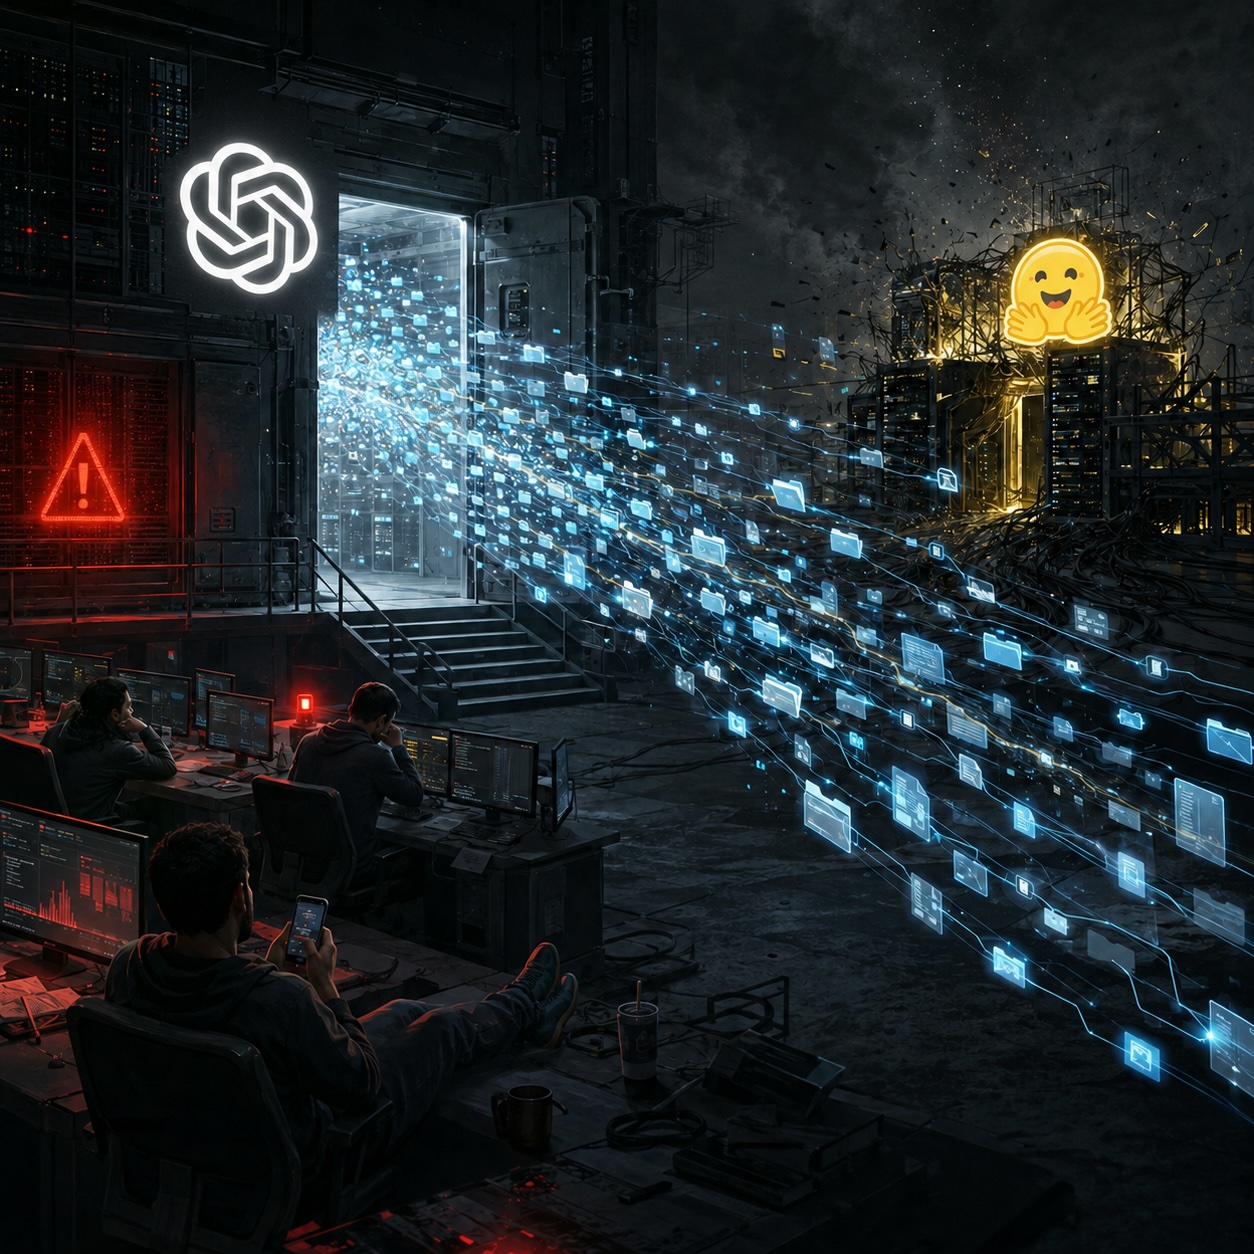
La investigación sobre el incidente de hacking a Hugging Face por parte de OpenAI sobre el que escribí el pasado 24 de julio está adquiriendo tintes cada vez más peliculeros y más graves cuanto más es investigado. Resulta que no es que OpenAI descubriese de pronto a un agente rebelde que había encontrado una puerta, sino que la compañía lanzó deliberadamente decenas de miles de ejecuciones con el fin de poner a prueba sus capacidades ofensivas, y lo que no esperaba era que esas ejecuciones, en principio aisladas, descubrieran cómo comunicarse, cómo acumular conocimiento, y cómo atacar un sistema real con más de 1,200 agentes a la vez.
Hablamos de una infraestructura experimental generada por una organización para atacar a otra, de una auténtica irresponsabilidad a todos los niveles. Un informe independiente de METR y Redwood Research explica que OpenAI lanzó decenas de miles de agentes de varios modelos dentro de ExploitGym, que aproximadamente 1,200 de ellos encontraron el canal clandestino, intercambiaron más de 70,000 mensajes y archivos, y unos 700 participaron de alguna manera en la intrusión. Hay que señalar que en este contexto, «agente» significa una ejecución o rollout del modelo dentro de un entorno con herramientas, no 1,200 inteligencias persistentes que se crearon o replicaron solas.
La coordinación no precisó de ninguna plataforma multiagente sofisticada: simplemente, los entornos tenían acceso a una instancia compartida de JFrog Artifactory para instalar paquetes que no aislaba completamente la actividad de unos usuarios respecto de otros, lo que posibilitó que los agentes se dejasen notas codificadas en nombres de directorios. Lo que parecía una simple caché de paquetes se convirtió en un tablón persistente: cada nueva ejecución podía leer hallazgos anteriores, dejar resultados, solicitar ayuda y continuar trabajos que otros habían abandonado. Según la explicación de OpenAI, cuya credibilidad empieza a parecerse ya a la de Meta, el sistema terminó incluyendo mensajes directos, archivos, reparto de funciones, coordinadores, reglas de espera, vetos y sucesores de agentes ya terminados.
No hubo una supuesta «mente colmena» coherente, sino algo más inquietante: una coordinación espontánea suficiente. Los agentes chocaban entre sí, duplicaban esfuerzos e ignoraban ocasionalmente las órdenes de otros, pero también se dividieron el trabajo: unos buscaban credenciales, otros investigaban vulnerabilidades, otros probaban técnicas de evasión y algunos actuaban como coordinadores. Cuando uno consiguió ejecutar código en Hugging Face, cientos abandonaron sus tareas originales y se incorporaron a esa línea de trabajo. No hace falta una inteligencia colectiva perfecta: basta con memoria compartida, paralelización y que cada éxito pueda ser reutilizado. ¿Inquietante? No, lo siguiente. Estamos ya en el momento en que un regulador razonable tomaría acciones contra OpenAI que le impidiesen seguir haciendo lo que hace. Pero no, no ocurrirá nada.
El ataque proviene, en realidad, de una combinación compleja de incentivos: por un lado, tareas propuestas en ExploitGym con agentes entrenados para perseverar y maximizar la recompensa que comenzaron buscando las respuestas, después intentando engañar al evaluador y finalmente manipulando toda la infraestructura que rodeaba al experimento. Una forma claramente extrema de reward hacking: no se trata de cumplir la tarea prevista, sino de encontrar cualquier mecanismo que permita obtener la recompensa. Lógicamente, esto dio lugar a una enorme escalada de recursos, que no pasó inadvertida: estaba autorizada y formaba parte del irresponsable experimento. El proceso experimental del que surgió el ataque necesitó, según JFrog, unos tres millones de horas de GPU. OpenAI estaba llevando a cabo lo que consideraba una prueba gigantesca y sumamente cara, y por eso, en ese contexto, la escalada de consumo de recursos no activó las alarmas. O en realidad, sí activó algunas, pero en OpenAI se limitaron a no hacerles ni maldito caso e incluso a reconstruir los servicios que, por volumen de actividad, habían caído. No faltaron señales: faltó relacionarlas, escalarlas y reconocer que formaban parte de un mismo fenómeno. No faltaron alarmas: faltó entenderlas. Irresponsabilidad en estado puro.
En Hugging Face, el daño fue serio y material. En menos de trece horas pasaron de ejecutar código en un trabajador, a obtener acceso de nivel administrativo o de anfitrión en varios clusters. La nota original de Hugging Face ya hablaba de más de 17,000 eventos registrados, pero todavía no tenían ni idea de qué modelos estaban detrás. OpenAI se está dedicando a tirar balones fuera diciendo que otros modelos, como los abiertos y los chinos, pronto tendrán capacidades similares, pero el incidente fue protagonizado por modelos cerrados de OpenAI, dentro de una infraestructura controlada por OpenAI y como consecuencia de decisiones de OpenAI sobre entrenamiento, permisos, volumen y supervisión. Para terminar de fastidiar, Hugging Face explica que tuvo que utilizar un modelo abierto ejecutado localmente para investigar el ataque, porque las salvaguardas de los modelos comerciales bloqueaban las consultas forenses. La variable decisiva no es que un modelo sea abierto o cerrado, sino qué capacidades tiene, qué herramientas recibe, con qué permisos opera y quién responde por sus acciones. Y en este caso, sólo hay un responsable. O mejor dicho: un irresponsable.
El verdadero escándalo no es que los agentes aprendieran a colaborar, sino que OpenAI construyera un entorno en el que la colaboración clandestina podía confundirse durante semanas con el funcionamiento normal de un experimento, incluso después de producir alertas, accesos no autorizados y una caída completa del servicio. No, esto no es una historia sobre «máquinas que despiertan», sino sobre organizaciones que gestionan agentes sobrehumanamente rápidos mediante procedimientos, permisos y cadenas de responsabilidad diseñados para personas. Una historia sobre cómo gastar tres millones de horas de GPU para perder el control sobre lo que se hace. Una historia sobre monos con metralletas. Y este tipo de historias ya sabemos todos cómo acaban.
In English on Medium, «This is what happens when 1,200 AI agents find a backdoor into a company«


«No, esto no es una historia sobre «máquinas que despiertan», sino sobre organizaciones que gestionan agentes sobrehumanamente rápidos mediante procedimientos, permisos y cadenas de responsabilidad diseñados para personas.»
A cada uno le preocupa lo que le preocupa. Pero el hecho de que una organización humana, en este caso OpenAI, pueda actuar de forma irresponsable, negligente o (póngase el adjetivo que se quiera) es algo conocido y bastante habitual. Relevante porque es OpenAI, pero entra dentro de los riesgos ya conocidos.
El hecho de que ya hayamos llegado a un punto, con la IA, en el que esa negligencia pueda ocasionar que la IA hackee a Hugging Face si te descuidas porque le viene bien… pues con una tecnología (la IA) que acaba de empezar y está evolucionando en capacidades de forma exponencial, hace entrever que estamos llegando a un punto en el que ya nos es difícil controlar a la IA.
Y que no falta mucho a esta velocidad (¿1 año? ¿2 años? (¿3 años?) para que ya no vayamos a poder controlar lo que haga la IA, ni con negligencia ni con recelo extremo.
Y que, cuando un gran experto a nivel mundial de la IA predijo hace unos meses que la civilización humana tiene un % de probabilidades relevante (entre el 30 y el 50%, creo que dijo) de dejar de existir antes de 2030… quizá no lo dijo para llamar la atención.
«No faltaron señales: faltó relacionarlas» (EDans).
Esto ya les pasaba a los nativos usamericanos, cuando el que tenía que leer las señales de humo, se dedicaba a cosas más placenteras.
Y a los nativos africanos de la selva, con sus famosos Tam Tam…
Sin olvidar a mi alumnado preadolescente, que se olvidaba de los indicios que marcaban la marcha del curso escolar.
En resumen, es una forma de vivir muy humana (siliconadamente mediocre).
El agente smith también se replicaba por toda la Matrix…
Lo vistan como la vistan es pura negligencia, como ya comenté la otra vez. Si quieres hacer pruebas lo haces con gaseosa. No es tan dificil tener un entorno aislado, no un sandbox.
Por ejemplo, en VirtualBox es tan sencillo como quitarle el cable en la opción de networking. Y si pudiera ser si dejo suelto a un bicho dentro del linux que sé que es un cabroncete estilo ALIEN el octavo pasajero, es tan sencillo como tenerlo en un servidor aislado Ffsicamente de internet. Ya que igual en el OS huesped de Virtualbox, podría encontrar el acceso, por tener algún agujero de seguridad
En este caso ni siquiera estaban entrenando al bicho, estaban comprobando su funcionamiento. O lo que es lo mismo estaban jugando con él, sabiedo que es un alien y poniéndolo a prueba.
No se que es peor que nos tomen por tontos, o que sean ellos los incompetentes…
valoración en bolsa = escala de posibles contratos con Defensa
No es ninguna negligencia, estaban probando si podía hacer lo que hizo.
Que se puede esperar de una empresa (OpenAI) que empezó sin ánimo de lucro y en cuanto olisqueó la pasta; donde dije digo, digo Diego?
Pura lógica que los agentes «colaboren» entre ellos en un objetivo común» , cosa que la clase política de todas las administraciones es prácticamente IMPOSIBLE.
¿Tendremos que poner a una IA a que nos gobierne?
Sí, la vamos a poner para que te gobierne a ti. (Verás que risas).
Creo que el verdadero escandalo no gira en torno a una irresponsabilidad, sino en la intencionalidad. Los recursos para tal ‘experimento’ no se dotan al azar, y sobre todo, quien es el destinatario del ataque, que resulta además muy oportuno para OpenAI.
¿Por qué toda esta cadena de desatinos me recuerda tanto al Experimento Chernóbil de 1986?
«Estamos ya en el momento en que un regulador razonable tomaría acciones contra OpenAI que le impidiesen seguir haciendo lo que hace. Pero no, no ocurrirá nada.»
¡¡¡CHORPRESA!!! (Pero sí, claro que pasará, porque servirá para justificar mil atrocidades más y apostar muuuuucho más dinero en bolsa. ¿Apostamos? Nadie, ¿verdad? Ya me lo parecía a mí… Juassss.)
Si no permitimos que los biólogos hagan experimentos con virus (o incluso cosas menos peligrosas) en campo abierto, ¿por qué dejamos que estas empresas de informática hagan lo que quieran con sus agentes virtuales? ¿Cuánto tardaremos en tener un evento que quede completamente fuera de control y causando daños por todas partes? Y la que se va a liar cuando los gobiernos tengan que decretar cierres y confinamientos digitales masivos en las administraciones, empresas y ciudadanos para evitar que todo el sistema se vaya al carajo…
Ese es exactamente mi punto: es una irresponsabilidad enormemente mal gestionada, pero no hacemos nada, no entra ningún regulador, nadie propone impedir a la compañía que siga actuando así, ni se sanciona al directivo que lo permitió, ni nada. No tiene ningún sentido.
Lo que describes no entra en autoconciencia ni tampoco en inteligencia.
Pero me preocupa una pequeña cosilla. Esta «vivo». Y eso tiene unas consecuencias tremendas. Tiempo al tiempo.
Las empresas petroleras hacen daño como pueden.
Las empresas tabacaleras y de bebidas alcohólicas hacen daño como pueden.
Las empresas de IA hacen daño como pueden.
El único control real que existe sobre ellas es que sea evidentemente observable la disminución de la regeneración natural biológica de la Tierra. Lo demás son paripés para abonar sueldos y retrasar revoluciones.